By SangyaPundir - Own work, CC BY-SA 4.0, https://commons.wikimedia.org/w/index.php?curid=53414062
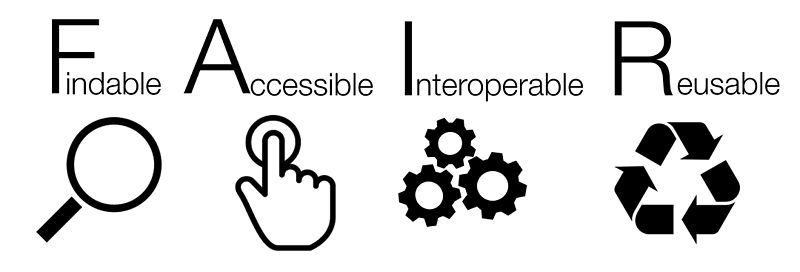
Helt siden en rekke forskere møttes i Leiden i 2014 og kom frem til FAIR-prinsippene har dette vært et "buzz word" innen åpen forskning. Forskningsdata skal være Findable, Accessible, Interoperable, Reusable, altså gjenfinnbare, tilgjengelige, interoperable og gjenbrukbare. Det betyr ikke at dataene nødvendigvis skal være åpent tilgjengelig, men metadataene til dataene må være åpne, slik at dataene i det minste er gjenfinnbare.
Dette er enklere sagt enn gjort. Data blir bare mer og mer tilgjengelige, og det blir stadig lettere å samle inn mer data fra flere kilder på kortere tid. Du kan oppbevare større datasett og kjøre tyngre analyser. Men om du vil ha gode metadata knyttet til disse dataene og du vil at disse metadataene skal være tilgjengelige for andre, da har du en solid jobb å gjøre. IT-løsningene som skal hjelpe deg med dette finnes ikke ennå.
 Skriv inn bildetekst her...
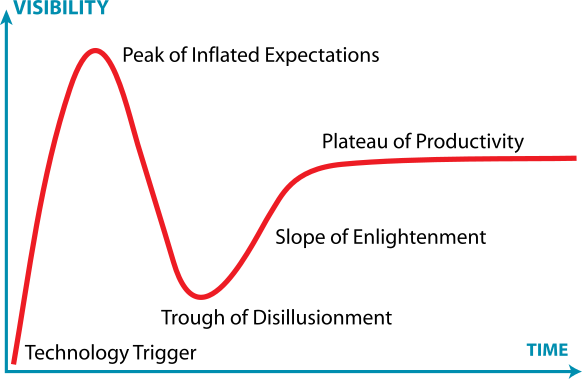
Er FAIR forskningsdata bare en "hype" som aldri vil nå et såkalt platå av produktivitet? George Strawn [1] hevder at det første som må på plass for at forskning skal bli FAIR er nettopp de tekniske løsningene. Uten tekniske løsninger er det rett og slett for vanskelig å få til FAIR data og skikkelig åpen forskning.
Dette jobber vi med her i TASK. Siden høsten 2020 har vi jobbet med å utvikle en teknisk løsning for å generere metadata for forskningsdata (filer, datasett, osv.), så automatisk som mulig. Målet er at forskerne og datarøkterne som bruker denne løsningen bare skal måtte oppgi et minimum av metadata manuelt, og alt annet som er tilgjengelig av informasjon om dataene fra andre digitale kilder skal kunne hentes automatisk og hektes på forskningsdataene. Det vil si at metadata om dataene generes automatisk og kan (hvis og bare hvis forskeren vil det) gjøres tilgjengelig på åpne nettsider. På den måten håper vi både at det skal bli lettere å holde orden på store datasett, og ikke minst lettere å gjøre forskningsdata FAIR.
Du kan lese mer om prosjektet vi jobber med her.
[1] George Strawn; Open Science and the Hype Cycle. Data Intelligence 2021; 3 (1): 88–94. doi: https://doi.org/10.1162/dint_a_00081