Kvantitativ analyseprogramvare som SPSS, Stata og R forutsetter data i tabulær form, det vil si sirlig ordnet med en kolonne for hver variabel, og en rad for hver observasjon. For å komme dithen må iblant rådataene bearbeides og omstruktureres.
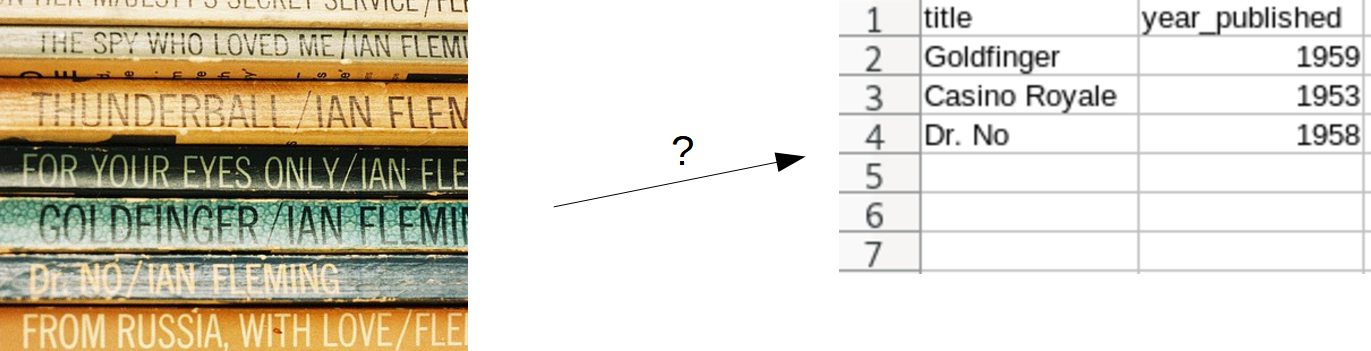
Eksempel: Datamaterialet består av tekster i ulike sjangre, og forskeren er interessert i sammenhengen mellom sjanger og hyppighet av enkelte ord. Første trinn blir dermed å telle opp ord i hver tekst, og å lagre antallene i en tabell av ønsket format. Det blir fort uoverkommelig med allment brukte IT-verktøy, med mindre man begrenser seg til svært få tekster.
Andre eksempler er måledata fra en MR-maskin lagret i xml-filer, og stemmedata fra et parlament som var publisert i pdf-format (som ikke er et rent tekstformat, men ofte kan tekstinnhold dras ut).
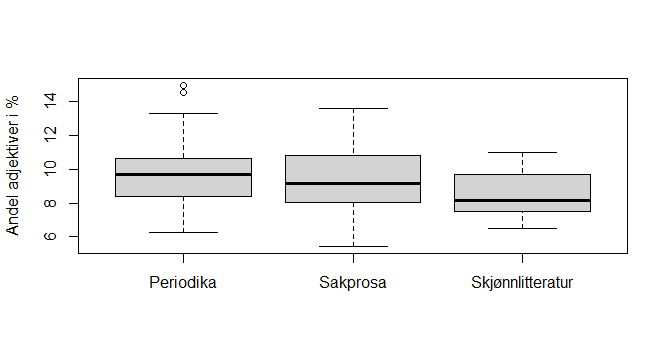
Felles for alle eksemplene er at rådata foreligger i et mer eller mindre strukturert tekstformat, og at forskeren har et ønske om hvilke variabler som skal hentes ut og tabuleres. En løsning må bestå i å
- Komme fram til en metode for hvordan variablene hentes ut fra råmaterialet
- Dernest å få datamaskinen til å utføre metoden.
Det kan sant å si bli noen runder prøving og feiling mellom punkt 1 og 2. Uansett gjør vi metodiske valg. Eksempel: Forskeren ønsker å telle antall setninger i en tekst. En rimelig metode er å telle opp punktum, spørsmålstegn og utropstegn, men kan det finnes øvrige skilletegn vi bør ta med? I så fall, vil det ha betydning for analyseresultatet? Ikke nødvendigvis, men reproduserbar forskning er basert på at metodevalg dokumenteres.
I TASK programmerer vi gjerne tekstbearbeiding i Python. Dermed er metodikken, om ikke annet, dokumentert i form av et Python-skript. Sammenliknet med typiske statistikkverktøy, er Python mer tilpasset å håndtere et mangfold av datastrukturer (altså data som ikke umiddelbart lar seg ordne i rader og kolonner). Python kommer dessuten med mye spesialverktøy for tekstdata. Antakelig finnes mange egnede programmeringsspråk. Blant dem er Python relativt lett å lære, og dessuten meget populært. Derfor er det lett å finne hjelp på internet (eller nabokontoret), og mange nyttige løsninger har allerede blitt laget.
For å komme i gang med Python selv, trengs noe tid til å lære programmering, og det trengs programvare på datamaskinen. Vi anbefaler sterkt å bruke Python-versjon 3 til å håndtere tekstdata. I tillegg til selve Python er det et minimumskrav å ha en teksteditor å skrive programmer i. Det enkleste er å installere Anaconda som inneholder Python og teksteditor og et stort utvalg av nyttige tilleggspakker. Litt mer vante brukere kan velge Miniconda for å spare plass.
Kurs i Python for UiO-forskere annonseres på denne nettsiden. De som ønsker å studere selv, har veldig mye å velge blant. Ett tips er å starte med denne boka. Den gjennomgår, i tillegg til grunnleggende Python-ferdigheter, de viktigste temaene innen teksthåndtering.
Forskeres behov er dog høyst ulike. Ta gjerne kontakt med oss i TASK for en mer konkret prat enn denne bloggposten rommer.